Un buscador de imágenes con IA (parte I): de píxeles a vectores
- 53 minsMotivación
Cuando pensamos en visión por computadora, lo primero que suele venir a la mente es entrenar una red neuronal: juntar miles de imágenes etiquetadas, elegir una arquitectura, rentar GPUs y esperar. Sin embargo, hoy existen modelos ya entrenados con cientos de millones de imágenes que podemos reutilizar tal cual para resolver problemas nuevos.
Esta serie de publicaciones nace de un taller de nivel intermedio que preparé para personas con Python básico y nociones de NumPy y pandas. En él construimos, en menos de dos horas, un pequeño sistema de visión por computadora sin entrenar ninguna red neuronal: usamos un modelo preentrenado (CLIP) para convertir imágenes satelitales en vectores de números y, con esos vectores, visualizamos el dataset completo, buscamos imágenes parecidas y clasificamos imágenes con muy pocos ejemplos.
La pregunta que guía todo el recorrido es:
¿Basta un modelo de IA general para entender imágenes de un dominio específico, o necesitamos nuestros propios datos?
La serie tiene dos partes:
- Parte I (esta publicación): la imagen como dato, qué es un embedding, un mapa del dataset con PCA y UMAP, y un buscador de imágenes similares.
- Parte II: clasificación zero-shot con texto, clasificación con pocos datos y búsqueda de imágenes a partir de una frase.
Todo el código está en un notebook que puedes ejecutar directamente en Google Colab:

En esta publicación solo comparto los fragmentos de código más importantes; el notebook tiene el resto, además de ejercicios con solución.
La imagen como dato
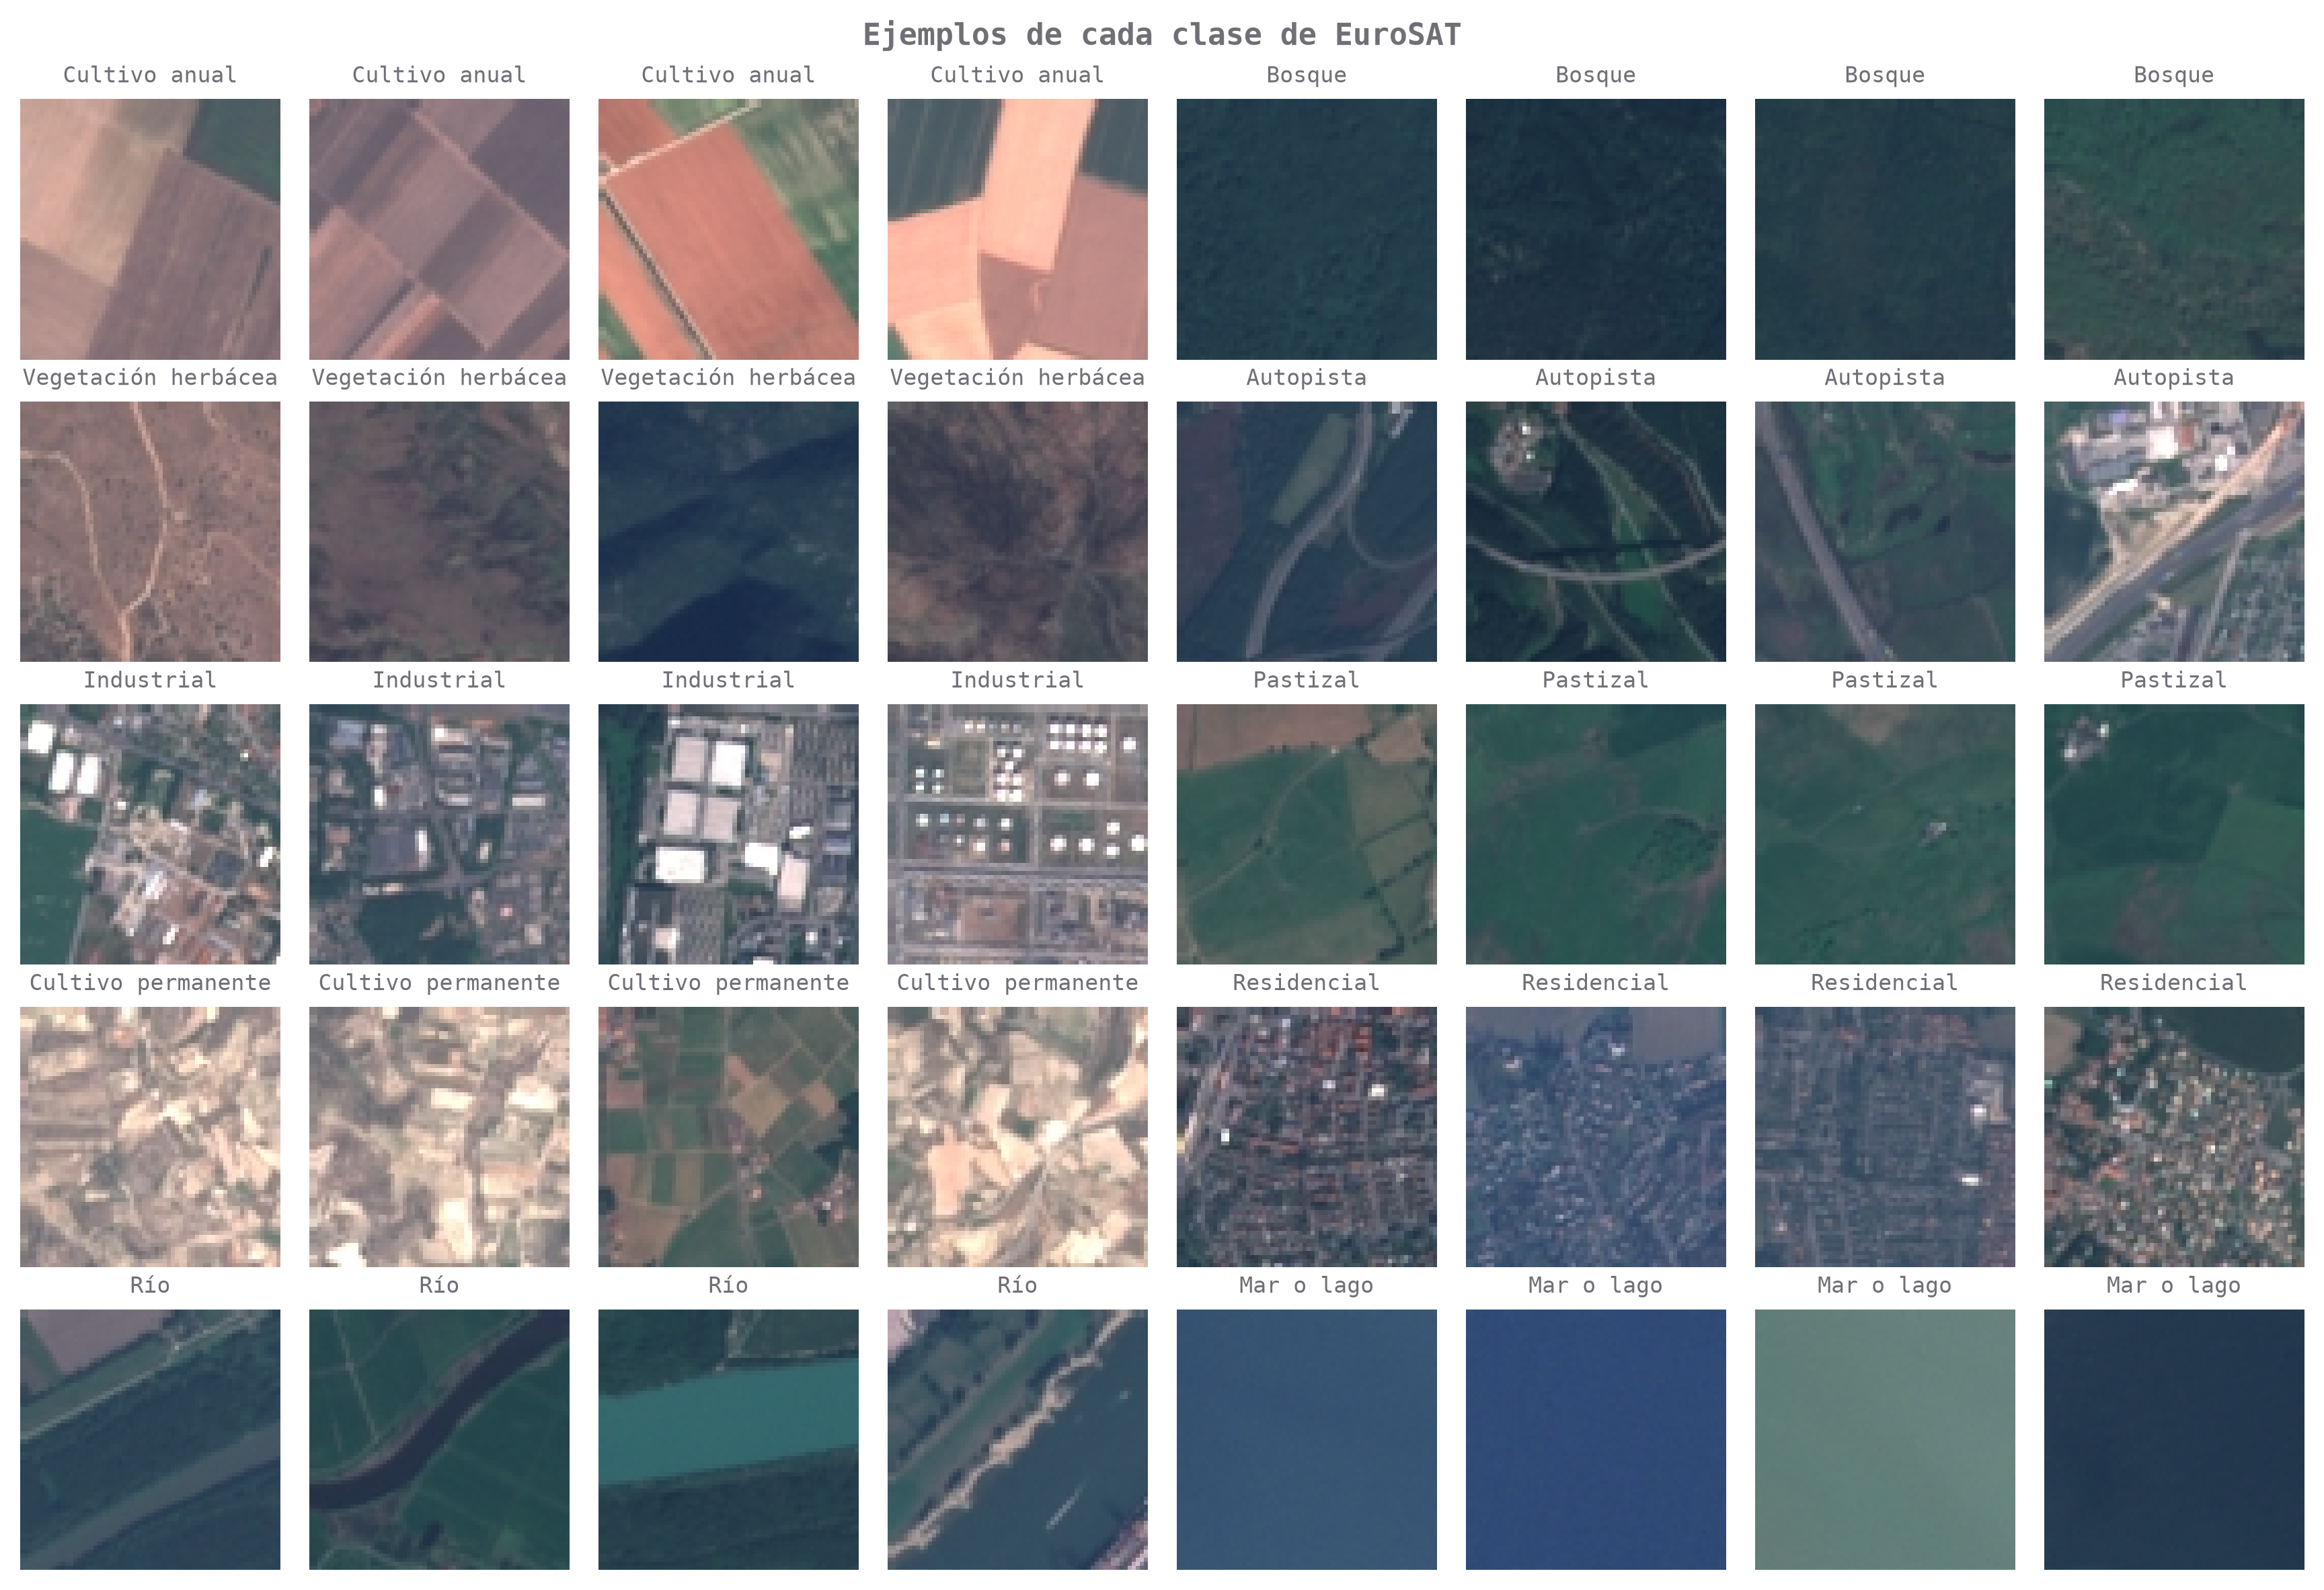
El dataset: EuroSAT
EuroSAT (Helber et al., 2019) contiene 27,000 imágenes satelitales tomadas por el satélite Sentinel-2 del programa europeo Copernicus. Cada imagen mide 64 × 64 pixeles y cada pixel cubre 10 × 10 metros, así que una imagen muestra un cuadro de unos 640 metros por lado. Las imágenes están etiquetadas en 10 clases de uso de suelo: bosque, río, autopista, zona residencial, distintos tipos de cultivo, etc.
📖 Definición · Imagen satelital y banda espectral
Un satélite de observación terrestre como Sentinel-2 no toma “fotos” como un celular: mide cuánta luz refleja la superficie en distintos rangos de longitud de onda, llamados bandas espectrales. Sentinel-2 mide 13 bandas: las tres que ve el ojo humano (rojo, verde y azul) y otras en el infrarrojo, que no podemos ver pero que revelan mucho, por ejemplo qué tan sana está la vegetación.
Una imagen “RGB” es la combinación de solo las tres bandas visibles, y por eso se parece a una foto común. A esta disciplina, analizar la Tierra con sensores a distancia, se le llama percepción remota.
Para que todo corra rápido trabajaremos con una muestra aleatoria y balanceada de 200 imágenes por clase (2,000 en total). Al tener la misma cantidad de imágenes de cada clase, elegir una clase al azar acertaría exactamente 1 de cada 10 veces: ese 10% será nuestra referencia para saber si algo funciona.
Una imagen es un arreglo de números
Para la computadora, una imagen a color es un arreglo de tres dimensiones: alto × ancho × 3 canales (rojo, verde y azul). Cada valor va de 0 (sin intensidad) a 255 (intensidad máxima), porque cada uno se guarda en 8 bits y con 8 bits se pueden representar 2⁸ = 256 valores distintos.
img = np.array(Image.open(ruta))
print(img.shape, img.dtype)
# (64, 64, 3) uint8   -> 64 × 64 × 3 = 12,288 números
Cada canal es simplemente una “rebanada” del arreglo, una matriz de 64 × 64:
canal_rojo = img[:, :, 0]
canal_verde = img[:, :, 1]
canal_azul = img[:, :, 2]
Para ver qué aporta cada canal, construimos una imagen RGB en la que solo ese canal está encendido y los otros dos valen cero:
def solo_canal(canal, posicion):
    capa = np.zeros_like(img)        # imagen negra de 64 × 64 × 3
    capa[:, :, posicion] = canal     # encendemos un solo canal
    return capa

rojo = solo_canal(canal_rojo, 0)
verde = solo_canal(canal_verde, 1)
azul = solo_canal(canal_azul, 2)

np.array_equal(rojo + verde + azul, img)   # True
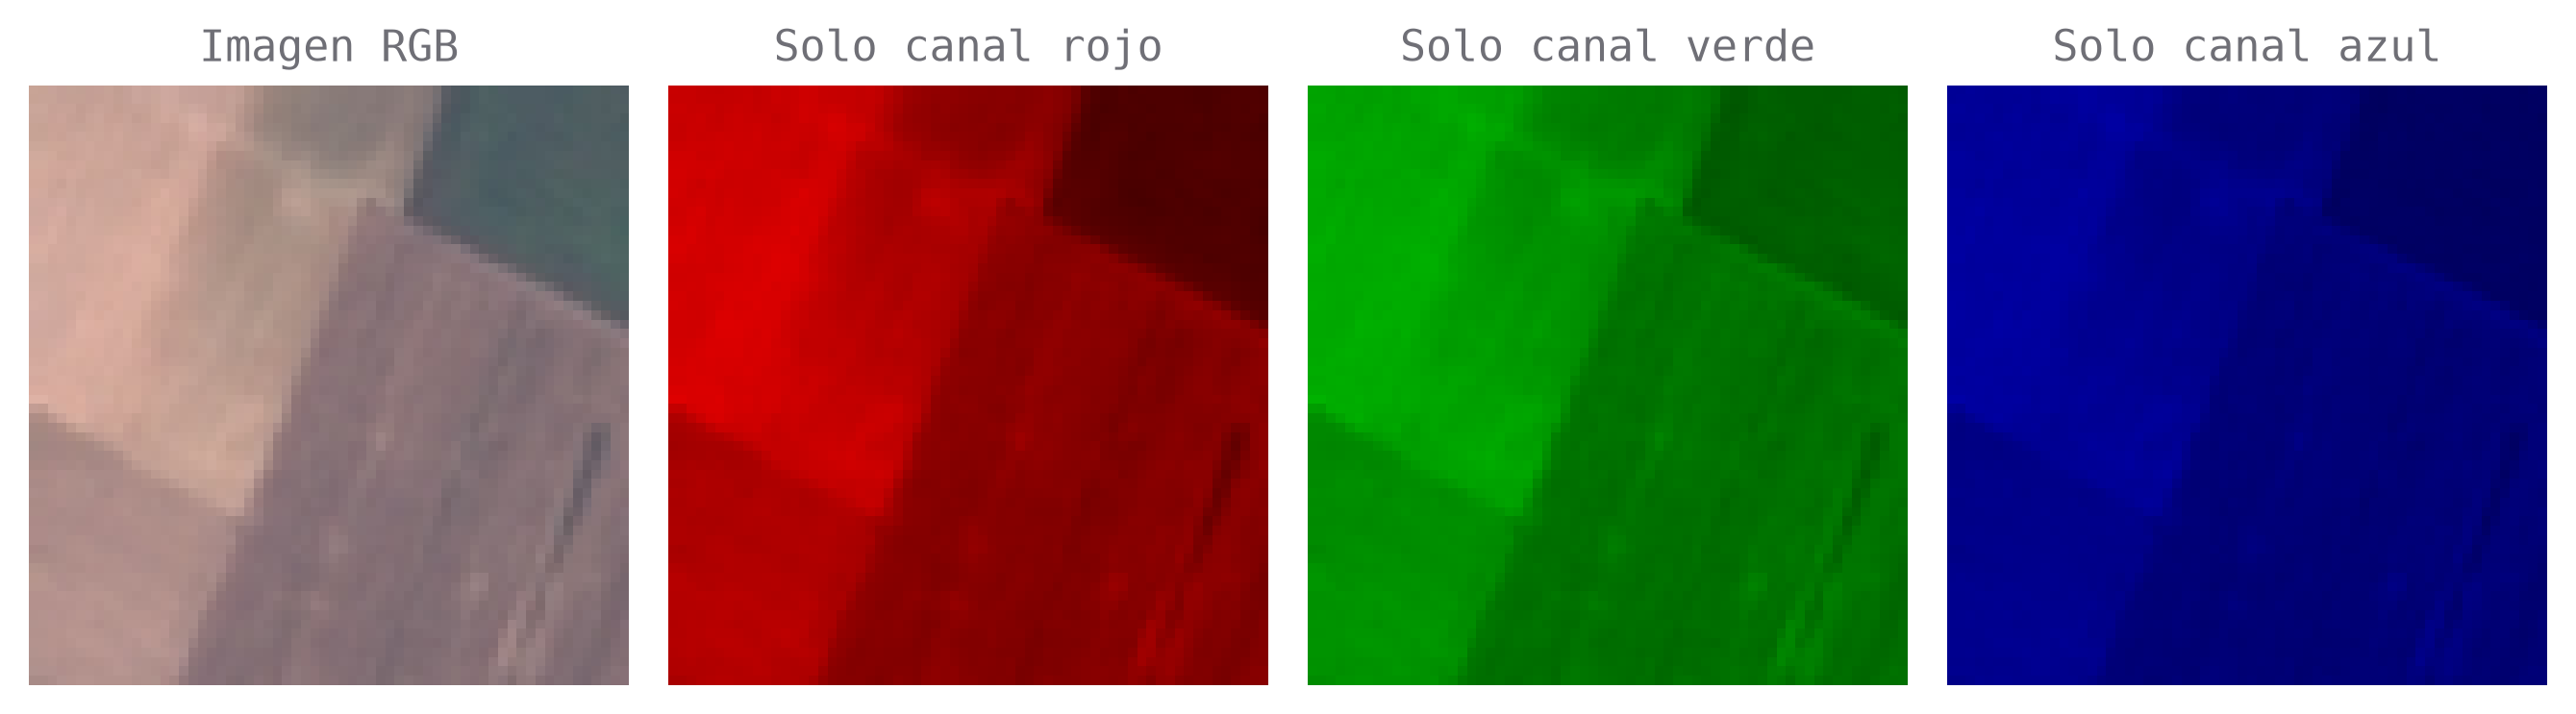
Cada panel muestra solo la luz de un canal: oscuro donde ese color casi no aparece y brillante donde aparece mucho. Por ejemplo, el campo de la esquina superior derecha casi desaparece en el canal rojo pero conserva brillo en el verde, y por eso se ve verdoso en la imagen original. Como las tres capas no se enciman, sumarlas reconstruye exactamente la imagen original.
El problema: 12,288 números por imagen son muchos, y los pixeles individuales no dicen mucho por sí solos. Si movemos la imagen un pixel, casi todos los valores cambian, aunque el contenido sea el mismo. Necesitamos una representación que capture qué hay en la imagen, no el valor exacto de cada pixel. Eso es un embedding.
¿Qué es un embedding?
Un embedding es un vector de números que resume el contenido de un dato (una imagen, un texto, un audio). La idea clave es:
Datos con contenido parecido tienen vectores cercanos.
Piensa en un mapa: cada ciudad se describe con dos números (latitud y longitud), y las ciudades cercanas tienen números parecidos. Un embedding hace lo mismo, pero con cientos de “coordenadas” en lugar de dos, y para contenido en lugar de ubicación: dos imágenes de bosques quedan “cerca” en ese espacio, y una imagen de un bosque queda “lejos” de una de una ciudad. Nadie define a mano qué significa cada coordenada: el modelo las aprende durante su entrenamiento.
CLIP: un modelo que conecta imágenes y texto
Para obtener los embeddings usaremos CLIP (Contrastive Language-Image Pre-training), un modelo publicado por OpenAI en 2021. CLIP tiene dos “codificadores”, uno para imágenes y otro para texto, y los dos producen vectores en el mismo espacio. Eso significa que el vector de una foto de un bosque queda cerca del vector de la frase “a photo of a forest”, algo que aprovecharemos mucho en la segunda parte.
⚙️ Cómo funciona · El entrenamiento de CLIP
CLIP se entrenó con unos 400 millones de pares (imagen, texto) tomados de internet; por ejemplo, una foto y su pie de foto. El proceso, simplificado, es:
- Se toma un lote de pares, por ejemplo mil fotos con sus mil descripciones.
- El codificador de imágenes convierte cada foto en un vector, y el codificador de texto convierte cada descripción en otro vector.
- El modelo se ajusta para que el vector de cada foto quede cerca del vector de su descripción, y lejos de las otras 999 descripciones del lote.
Repetido millones de veces, esto obliga al modelo a capturar el contenido visual que describen las palabras. A este tipo de entrenamiento se le llama aprendizaje contrastivo.
Entrenar un modelo así requiere semanas de cómputo en cientos de GPUs. Por eso, en la práctica, casi nunca se entrena desde cero: se descarga un modelo preentrenado y se reutiliza lo que ya aprendió para un problema nuevo. A esta idea se le llama aprendizaje por transferencia (transfer learning). Usaremos la versión openai/clip-vit-base-patch32 desde Hugging Face, con 151 millones de parámetros.
📖 Definición · ¿Qué significa
clip-vit-base-patch32?
- ViT (Vision Transformer) es la arquitectura del codificador de imágenes. En lugar de recorrer la imagen con filtros, como una red convolucional, la corta en cuadros (patches) y analiza cómo se relacionan entre sí, igual que un modelo de lenguaje analiza cómo se relacionan las palabras de una oración.
- base es el tamaño del modelo: hay versiones más pequeñas y más grandes.
- patch32 indica que los cuadros miden 32 × 32 pixeles. CLIP trabaja con imágenes de 224 × 224, así que cada imagen se corta en 7 × 7 = 49 cuadros.
De imágenes a vectores
Con la biblioteca transformers, obtener los embeddings toma unas cuantas líneas. El procesador redimensiona y normaliza las imágenes como CLIP espera, y el modelo devuelve un vector por imagen:
from transformers import CLIPModel, CLIPProcessor

modelo = CLIPModel.from_pretrained("openai/clip-vit-base-patch32").eval()
procesador = CLIPProcessor.from_pretrained("openai/clip-vit-base-patch32")

@torch.no_grad()  # no vamos a entrenar: no necesitamos gradientes
def embeddings_de_imagenes(rutas, lote=64):
    vectores = []
    for i in range(0, len(rutas), lote):
        imagenes = [Image.open(r).convert("RGB") for r in rutas[i:i + lote]]
        entrada = procesador(images=imagenes, return_tensors="pt")
        v = modelo.get_image_features(**entrada)
        vectores.append(torch.nn.functional.normalize(v, dim=-1).numpy())
    return np.concatenate(vectores)

X = embeddings_de_imagenes(df["ruta"].tolist())   # (2000, 512)
Cada imagen quedó resumida en 512 números en lugar de 12,288: una reducción de 24 veces, y en una laptop con CPU tarda menos de medio minuto para las 2,000 imágenes.
Los números individuales no tienen un significado que podamos interpretar (no hay una “coordenada de bosque”). Lo que importa es la distancia entre vectores, y para medirla usamos la similitud coseno.
📖 Definición · Similitud coseno
La similitud coseno mide qué tan parecida es la dirección de dos vectores, sin importar su longitud:
\[\text{sim}(\mathbf{a}, \mathbf{b}) = \frac{\mathbf{a} \cdot \mathbf{b}}{\lVert \mathbf{a} \rVert \, \lVert \mathbf{b} \rVert} = \cos \theta\]donde $\theta$ es el ángulo entre los vectores. Vale 1 si apuntan en la misma dirección, 0 si son perpendiculares (sin relación) y −1 si apuntan en direcciones opuestas.
Como normalizamos los vectores para que tengan longitud 1, el denominador vale 1 y la similitud es simplemente el producto punto. Por eso, con una sola multiplicación de matrices (
X @ X.T) obtenemos la similitud entre todos los pares de imágenes a la vez.
En promedio, dos imágenes de la misma clase tienen una similitud de 0.889, y dos de clases distintas, de 0.809. Si promediamos por cada par de clases obtenemos la siguiente matriz:
De aquí podemos observar algunas cosas:
- En cada renglón, el valor más alto está en la diagonal: una imagen se parece más a las de su propia clase que a las de otras. CLIP nunca vio nuestras etiquetas, así que esa organización la aprendió por su cuenta.
- Todas las similitudes son altas (entre 0.68 y 0.93). Los embeddings de CLIP ocupan una región estrecha del espacio, así que el valor absoluto dice poco; lo que importa es la comparación relativa: qué imagen está más cerca que otra.
- Bosque y Mar o lago se parecen mucho (0.89): ambas son superficies oscuras y uniformes, con pocos detalles. En cambio, las zonas urbanas (Industrial, Residencial) son las más lejanas del agua.
Un mapa del dataset: PCA y UMAP
No podemos dibujar 512 dimensiones, pero sí podemos proyectarlas a 2 y ver si las clases se separan solas. A esto se le llama reducción de dimensionalidad: representar datos de muchas columnas con muy pocas, perdiendo la menor información posible. El precio es que siempre se pierde algo: ninguna proyección a 2 dimensiones conserva todo lo que hay en 512.
Comparamos dos técnicas muy distintas.
⚙️ Cómo funciona · PCA
PCA (Principal Component Analysis, análisis de componentes principales) busca las direcciones en las que los datos varían más y proyecta los datos sobre ellas. El proceso, de manera sencilla:
- Centrar los datos: restar a cada columna su promedio.
- Encontrar la dirección en la que los datos están más dispersos: ese es el primer componente principal.
- Encontrar la siguiente dirección de mayor dispersión, perpendicular a la anterior: el segundo componente. Y así sucesivamente.
- Proyectar cada dato sobre los primeros componentes; en nuestro caso, sobre los dos primeros.
La varianza explicada indica qué porcentaje de la dispersión total conservan los componentes elegidos. Como PCA es una proyección lineal (como la sombra de un objeto sobre una pared), no puede “desenrollar” estructuras curvas en los datos.
⚙️ Cómo funciona · UMAP
UMAP (Uniform Manifold Approximation and Projection) no busca direcciones de varianza: busca conservar quién es vecino de quién. El proceso, de manera sencilla:
- En el espacio original de 512 dimensiones, encuentra los vecinos más cercanos de cada punto y construye una red (un grafo) que los conecta.
- Coloca los puntos al azar en un plano de 2 dimensiones.
- Mueve los puntos poco a poco: acerca los que estaban conectados en la red y aleja los que no lo estaban, hasta que la red en 2D se parezca lo más posible a la original.
⚠️ Cuidado · Cómo leer un mapa de UMAP
En un mapa de UMAP, el tamaño de un grupo y la distancia entre grupos lejanos no tienen un significado preciso. Lo confiable es qué puntos quedan juntos.
Con scikit-learn y umap-learn, ambas proyecciones son una línea cada una:
from sklearn.decomposition import PCA
import umap

X_pca = PCA(n_components=2, random_state=42).fit_transform(X)
X_umap = umap.UMAP(n_neighbors=15, min_dist=0.1, metric="cosine",
                   random_state=42).fit_transform(X)
Con 10 clases, diez colores distintos serían difíciles de distinguir (sobre todo para personas con daltonismo), así que primero resaltamos tres clases y dejamos las demás en gris como contexto:
Ahora veamos todas las clases con UMAP, una por panel (lo que en visualización se llama small multiples):
¿Qué observamos?
- PCA con solo 2 componentes conserva el 41.7% de la varianza. Industrial se separa hacia un extremo, pero Bosque y Mar o lago quedan encimados en la misma franja.
- UMAP separa mucho mejor los grupos. Industrial y Residencial forman “islas” bien definidas; Bosque y Mar o lago quedan juntos, pero cada uno en su propia zona.
- Autopista, Río y Pastizal quedan dispersos en el centro del mapa, mezclados con otras clases. Esto nos anticipa dónde se va a equivocar cualquier modelo que construyamos con estos embeddings.
Un buscador de imágenes similares
Con los embeddings, un buscador es sorprendentemente sencillo: dada una imagen, ordenamos todas las demás por su similitud coseno y devolvemos las más parecidas. Esto es lo que hacen, a gran escala, la búsqueda por imagen de los buscadores web o la función de “productos similares” de una tienda en línea.
def buscar_similares(i, k=5):
    # Índices y similitudes de las k imágenes más parecidas a la imagen i
    similitudes = X @ X[i]
    similitudes[i] = -np.inf                 # excluimos la propia imagen
    vecinos = np.argsort(-similitudes)[:k]   # orden descendente
    return vecinos, similitudes[vecinos]
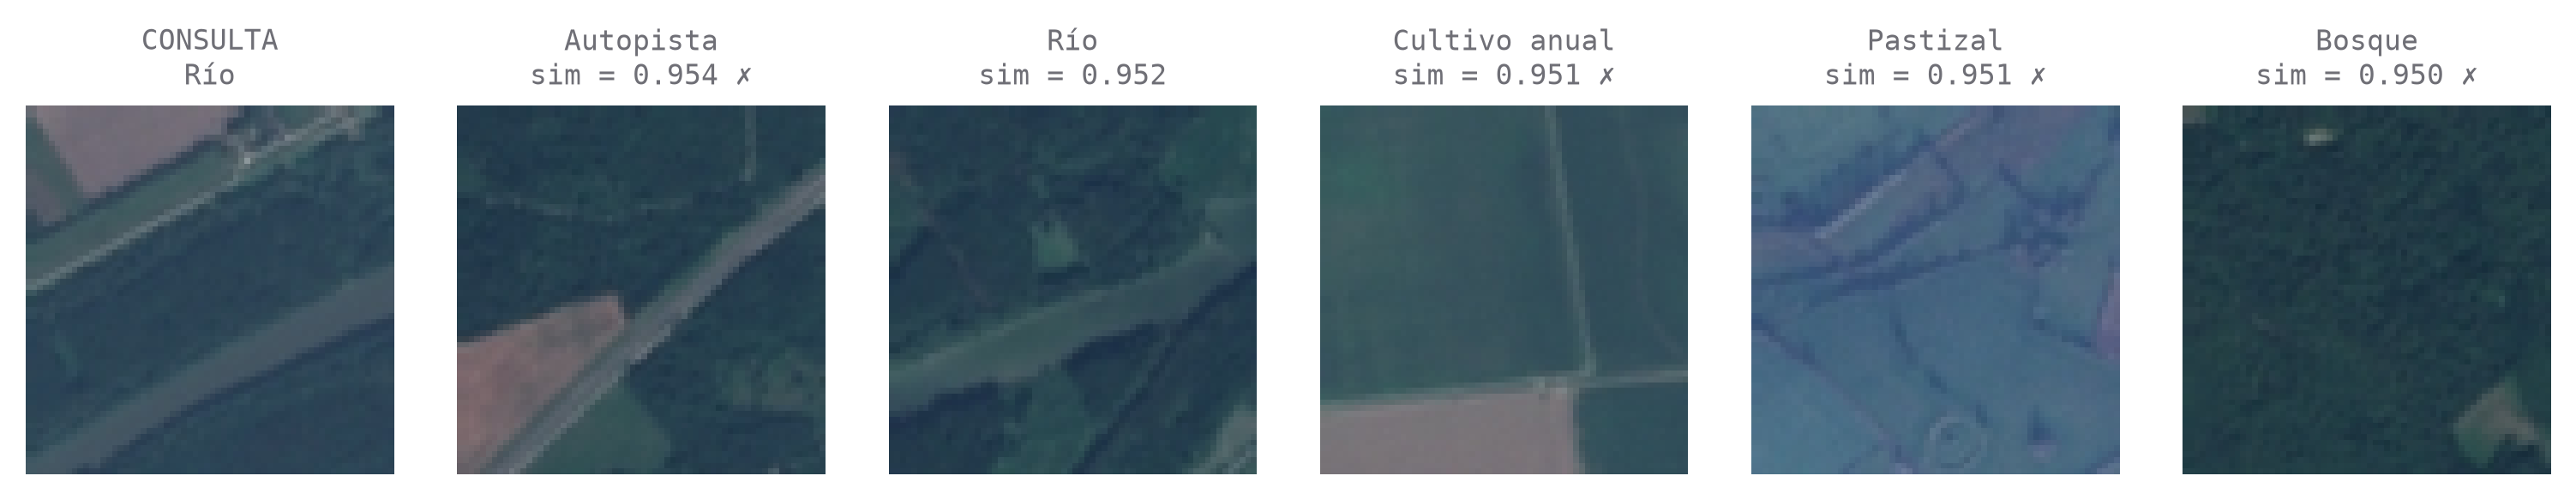
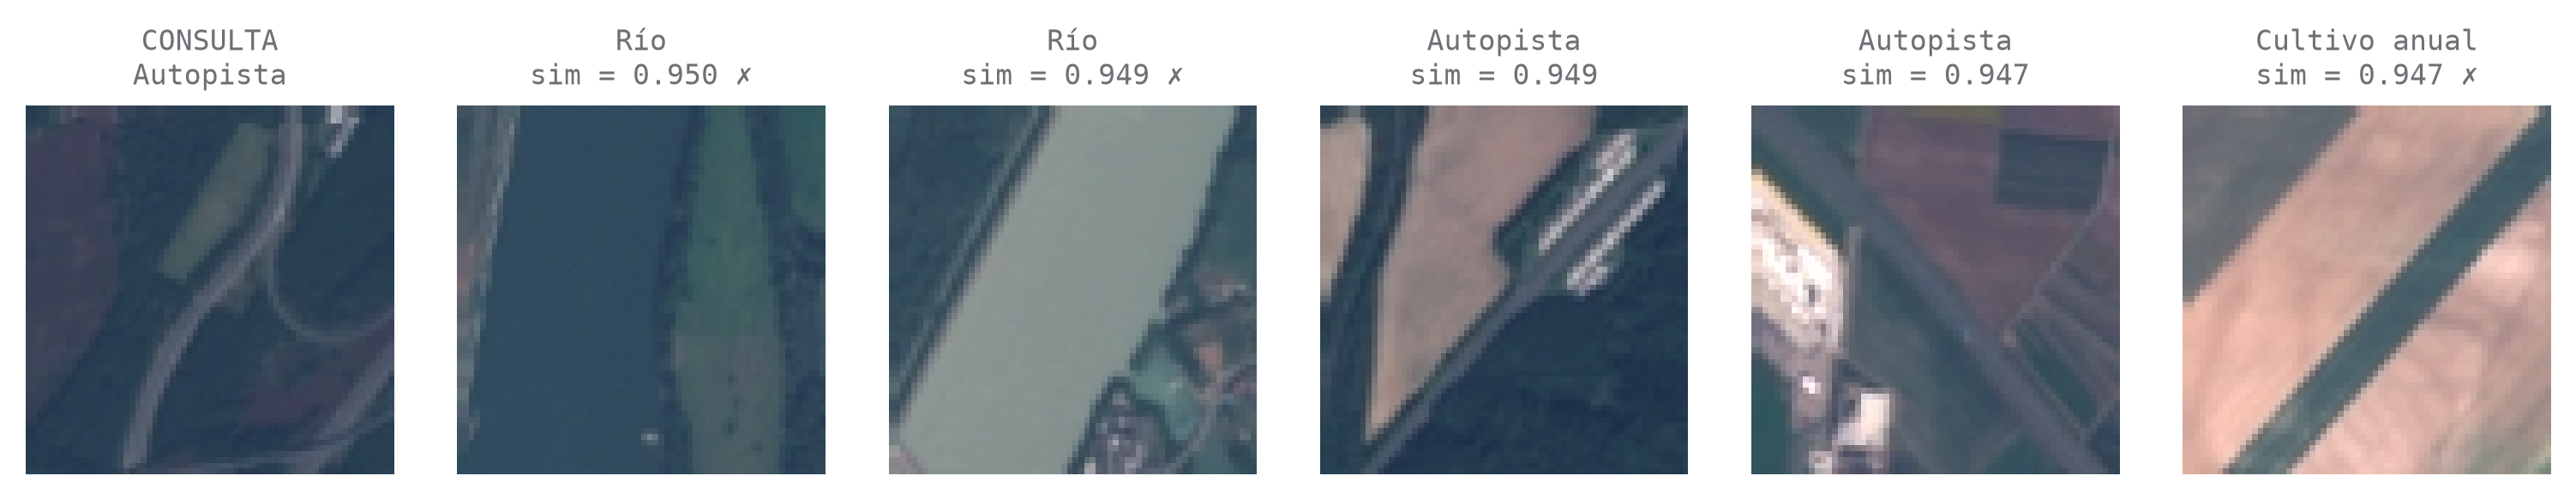
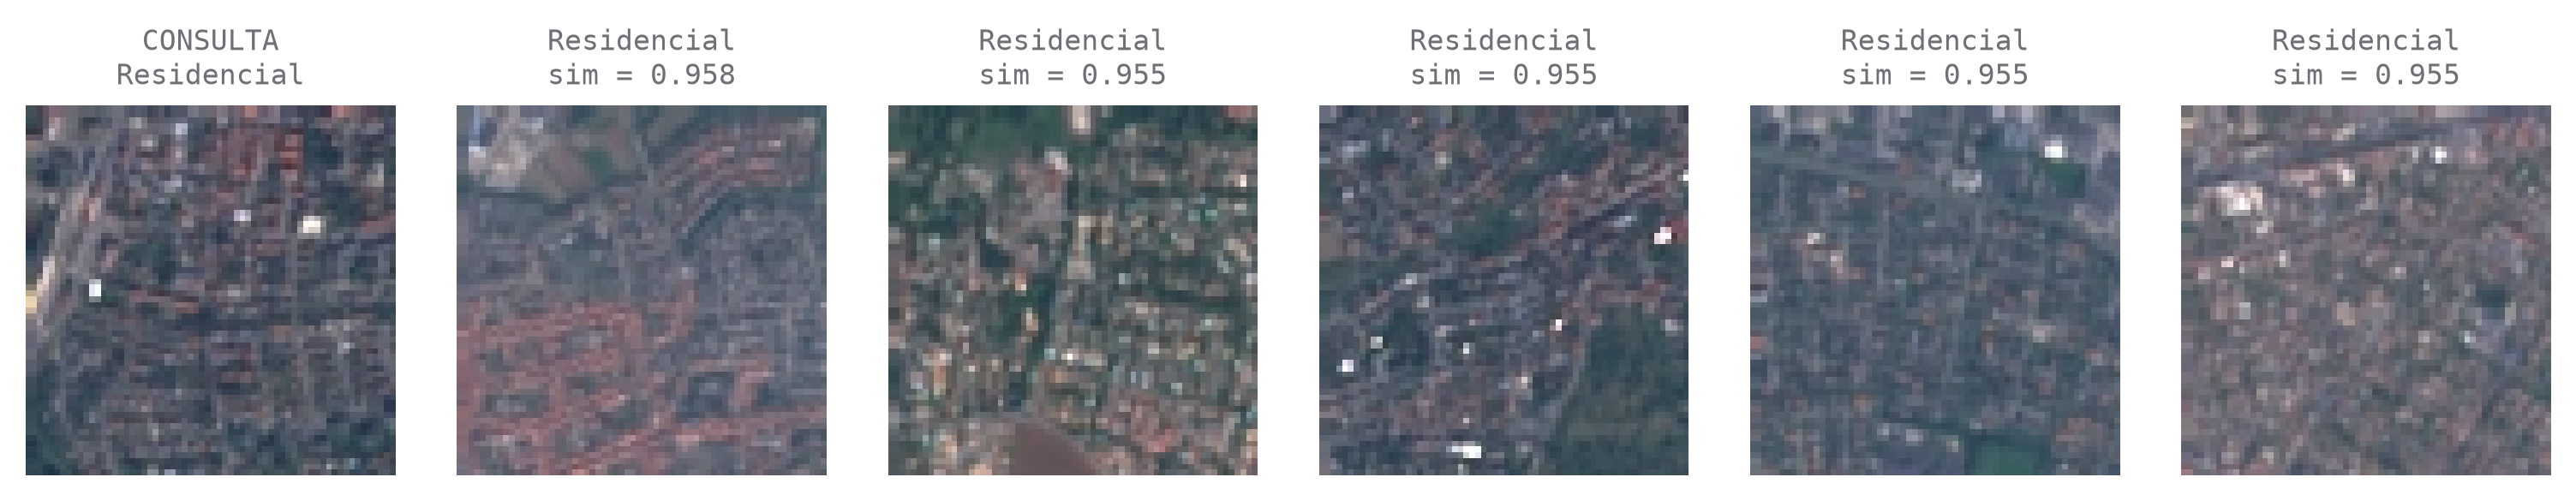
Sí, eso es todo el buscador: un producto punto y un ordenamiento. Veamos tres consultas, una de un río, una de una autopista y una de una zona residencial. La marca ✗ indica un resultado de una clase distinta a la de la consulta:
📖 Definición · Búsqueda por vecinos más cercanos
Lo que construimos se llama búsqueda de vecinos más cercanos (nearest neighbor search): dado un vector de consulta, encontrar los vectores del dataset más similares a él. Con 2,000 imágenes podemos compararlo contra todas (búsqueda exacta). Con millones de vectores eso sería muy lento, así que se usan índices de búsqueda aproximada, que sacrifican un poco de precisión a cambio de mucha velocidad. Es lo que hacen las bases de datos vectoriales, las mismas que usan los sistemas de IA que buscan información en documentos.
¿Qué tan bueno es el buscador?
Para medirlo en todo el dataset usamos la precisión en k (precision@k): de los k resultados, ¿qué proporción es de la misma clase que la consulta? Si buscamos las 5 imágenes más parecidas a un bosque y 4 de ellas son bosques, la precisión en 5 de esa consulta es 4 / 5 = 80%. La precisión del buscador es el promedio sobre todas las consultas.
K = 5
S = X @ X.T                          # similitud entre todos los pares: 2,000 × 2,000
np.fill_diagonal(S, -np.inf)         # una imagen no cuenta como su propio resultado
top_k = np.argsort(-S, axis=1)[:, :K]
aciertos = y_clase[top_k] == y_clase[:, None]
print(f"Precisión en {K}: {aciertos.mean():.1%}")   # 78.8%
- El buscador funciona sin haber entrenado nada: en promedio, el 78.8% de los 5 resultados son de la misma clase que la consulta, contra 10% si eligiéramos al azar.
- Las clases con textura uniforme son las más fáciles (Bosque, 94%). Las más difíciles son Autopista (61%) y Río (66%): a 10 metros por pixel, un río y una carretera son, ambos, una franja que cruza un terreno verde. Justo las clases que veíamos dispersas en el mapa de UMAP.
- La zona Residencial, en cambio, tiene una textura de calles y techos muy característica.
Conclusiones de la parte I
Hasta aquí, sin entrenar absolutamente nada, logramos:
- Convertir cada imagen de 12,288 pixeles en un vector de 512 números que resume su contenido.
- Verificar que esos vectores organizan las clases por su cuenta, aunque CLIP nunca vio nuestras etiquetas.
- Visualizar el dataset completo con PCA y UMAP, y anticipar qué clases van a ser difíciles.
- Construir un buscador de imágenes similares con una precisión en 5 de 78.8%, con un producto punto y un ordenamiento.
Pero el buscador solo nos dice qué imágenes se parecen; todavía no le pone nombre a lo que ve. En la parte II aprovecharemos que CLIP también entiende texto para clasificar imágenes sin ningún ejemplo etiquetado (zero-shot), veremos hasta dónde llega, y qué tanto mejora con unos pocos ejemplos de nuestros propios datos. Ahí responderemos la pregunta con la que empezamos.
SPOILER:
Con solo describir las clases en texto, CLIP acierta en menos de la mitad de las imágenes. Con 5 ejemplos etiquetados por clase, la exactitud sube a 65%, y con 150 por clase llega a 86%.
Referencias
- Helber, P., Bischke, B., Dengel, A. y Borth, D. (2019). EuroSAT: A Novel Dataset and Deep Learning Benchmark for Land Use and Land Cover Classification. IEEE Journal of Selected Topics in Applied Earth Observations and Remote Sensing.
- Radford, A. et al. (2021). Learning Transferable Visual Models From Natural Language Supervision. ICML.
- McInnes, L., Healy, J. y Melville, J. (2018). UMAP: Uniform Manifold Approximation and Projection for Dimension Reduction.
- CLIP ViT-B/32 en Hugging Face.
- Repositorio del taller: github.com/RodolfoFerro/buscador-imagenes-ia.
SOBRE EL USO DE INFORMACIÓN TOTAL O PARCIAL: 🔐
- Estos documentos fueron originalmente creados por el autor.
- Cualquier uso de estos documentos o sus contenidos están permitidos a través de la licencia provista y sus condiciones.
- Para cualquier aclaración, puedes contactar al autor: https://rodolfoferro.xyz/
Copyright (c) 2026 Rodolfo Ferro
Rodolfo Ferro
With great power comes great responsibility.