Un buscador de imágenes con IA (parte II): clasificar con (casi) cero etiquetas
- 26 minsRecapitulando
En la parte I convertimos 2,000 imágenes satelitales de EuroSAT en vectores de 512 números (embeddings) usando CLIP, un modelo preentrenado. Vimos que esos vectores organizan las 10 clases de uso de suelo por su cuenta, sin haber visto nunca nuestras etiquetas, y con ellos construimos un buscador de imágenes similares con una precisión en 5 de 78.8%.
Pero un buscador solo nos dice qué se parece a qué; no le pone nombre a lo que ve. En esta publicación vamos a clasificar las imágenes, y a responder la pregunta que guía toda la serie:
¿Basta un modelo de IA general para entender imágenes de un dominio específico, o necesitamos nuestros propios datos?
Como antes, el código completo está en el notebook del taller:

Antes de empezar, vale la pena poner nombre a los tres escenarios que vamos a comparar, según cuántos ejemplos etiquetados necesita cada uno:
| Término | Ejemplos etiquetados | En esta publicación |
|---|---|---|
| Zero-shot | Ninguno: solo una descripción de cada clase | Clasificar con frases |
| Few-shot | Unos cuantos por clase (1, 5, 10…) | La curva de aprendizaje |
| Entrenamiento supervisado | Muchos por clase | 150 imágenes por clase |
Para comparar todos los métodos de forma justa, separamos desde el inicio un conjunto de prueba de 50 imágenes por clase (500 en total) que ningún método ve antes de ser evaluado. Las 1,500 restantes (150 por clase) forman el conjunto de entrenamiento. La división es estratificada: cada clase conserva la misma proporción en ambos conjuntos.
Clasificación zero-shot: solo con texto
Como CLIP pone imágenes y textos en el mismo espacio, podemos clasificar sin entrenar nada:
- Escribimos una frase por clase, por ejemplo “a satellite photo of a forest”.
- Calculamos el embedding de cada frase.
- A cada imagen le asignamos la clase cuya frase sea más similar.
En código, es otra vez un producto punto, ahora entre imágenes y frases:
def zero_shot(plantilla, X_eval):
    # Clasifica cada imagen con la clase cuya frase sea más similar
    frases = [plantilla.format(NOMBRE_EN[c]) for c in CLASES]
    T = embeddings_de_textos(frases)          # (10, 512)
    return (X_eval @ T.T).argmax(axis=1)      # la frase más parecida gana
Aquí NOMBRE_EN traduce cada clase a un nombre “natural” en inglés (por ejemplo, SeaLake como “sea or lake”), porque CLIP se entrenó principalmente con texto en inglés.
📖 Definición · Prompt
Un prompt es el texto que le damos a un modelo para indicarle qué queremos. Aquí, cada prompt es la frase que describe una clase, y una plantilla es un prompt con un hueco (
{}) que se rellena con el nombre de cada clase. Ajustar estas frases para obtener mejores resultados, sin cambiar el modelo, se conoce como ingeniería de prompts.
Probamos tres plantillas:
| Plantilla | Exactitud |
|---|---|
{} (solo el nombre de la clase) | 36.6% |
a satellite photo of {}. | 42.0% |
a centered satellite photo of {}. | 44.8% |
La forma de escribir la frase importa: sin cambiar el modelo ni los datos, la exactitud pasa de 36.6% a 44.8%. Decirle a CLIP que es una foto satelital le da contexto. Aun así, 44.8% es poco para un sistema real: es mucho mejor que el azar (10%), pero se equivoca en más de la mitad de las imágenes.
¿En qué se equivoca?
Para saberlo usamos la matriz de confusión: cada renglón es la clase real y cada columna la clase predicha; la diagonal son los aciertos.
📖 Definición · Métricas de clasificación
- Exactitud (accuracy): proporción de imágenes clasificadas correctamente, sobre el total.
- Matriz de confusión: tabla que cruza la clase real con la predicha. Cada celda fuera de la diagonal indica qué se confunde con qué.
- Recall (sensibilidad) de una clase: de las imágenes que realmente son de esa clase, ¿qué proporción reconoció el modelo? Se lee por renglón.
- Precisión de una clase: de las imágenes que el modelo dijo que son de esa clase, ¿qué proporción lo es? Se lee por columna.
Con clases balanceadas, la exactitud es un buen resumen. Pero siempre conviene revisar la matriz de confusión: dos modelos con la misma exactitud pueden equivocarse de formas muy distintas.
- Industrial tiene el mejor recall (88%), pero porque CLIP lo predice demasiado: la columna Industrial recibe 127 predicciones, cuando solo hay 50 imágenes industriales. Muchos cultivos permanentes, ríos y zonas residenciales terminan ahí.
- Vegetación herbácea y Cultivo permanente tienen 0% de recall: CLIP nunca las predice (sus columnas están vacías). Sus nombres son términos técnicos que casi no aparecen en los textos de internet con los que se entrenó el modelo. La vegetación herbácea se confunde sobre todo con Bosque (27 de 50).
- Río solo tiene 10% de recall, por la misma razón que vimos en el buscador: a 10 metros por pixel, un río y una carretera se parecen mucho.
¿Y si cambiamos las palabras?
Si el problema es el vocabulario, podemos intentar describir esas dos clases con palabras más comunes. Cambiando “herbaceous vegetation” por “shrubland” y “permanent crop land” por “an orchard or vineyard”, la exactitud sube de 44.8% a 50.4%.
Sin embargo, hay dos advertencias importantes:
- Elegí esas frases viendo los resultados del conjunto de prueba. Eso es una forma de fuga de información: el 50.4% es optimista, porque ajustamos el clasificador a estas 500 imágenes en particular. En un proyecto real, las frases se ajustan con un conjunto de validación aparte, y el de prueba se usa una sola vez, al final.
- La ganancia es modesta: probando muchas variantes conseguimos unos 6 puntos. Como veremos enseguida, unos cuantos datos etiquetados valen mucho más que cualquier frase.
Clasificación con pocos datos
El zero-shot es cómodo, pero un modelo general no es experto en imágenes satelitales. La alternativa clásica sería entrenar una red neuronal desde cero, lo que requiere miles de imágenes y una GPU. Hay un camino intermedio muy usado en la práctica:
Usar los embeddings de CLIP como características (features) y entrenar encima un modelo sencillo, como una regresión logística.
Visto así, cada imagen es ahora un renglón con 512 columnas numéricas, y el problema se vuelve un problema de clasificación tabular como cualquier otro. A esta técnica se le conoce como linear probe.
📖 Definición · Linear probe frente a fine-tuning
Hay dos formas comunes de adaptar un modelo preentrenado a un problema nuevo:
- Linear probe (lo que haremos): el modelo preentrenado se queda congelado, solo se usa para calcular los embeddings, y se entrena un modelo sencillo encima. Es rápido, barato y funciona con pocos datos.
- Fine-tuning (ajuste fino): se siguen entrenando también los pesos del modelo preentrenado con los datos nuevos. Suele dar mejores resultados, pero requiere más datos, GPU y cuidado para no sobreajustar.
⚙️ Cómo funciona · Regresión logística con varias clases
A pesar de su nombre, la regresión logística es un modelo de clasificación. Para cada clase calcula un “puntaje” como una suma ponderada de las 512 columnas, y luego convierte los 10 puntajes en probabilidades que suman 1 (con la función softmax). La clase predicha es la de mayor probabilidad. Entrenar el modelo significa encontrar los pesos de esas sumas que mejor separan las clases en los datos de entrenamiento.
Con scikit-learn, son tres líneas:
from sklearn.linear_model import LogisticRegression

clf = LogisticRegression(max_iter=3000).fit(X_train, y_train)
print(f"Prueba: {clf.score(X_test, y_test):.1%}")            # 85.8%
print(f"Entrenamiento: {clf.score(X_train, y_train):.1%}")   # 86.7%
La exactitud casi se duplica: de 44.8% a 85.8%, con un modelo que se entrena en un par de segundos y sin GPU.
Comparemos el recall de cada clase con ambos métodos:
- Todas las clases mejoran, y las que más ganan son justamente las que CLIP no reconocía: Vegetación herbácea pasa de 0% a 84% y Cultivo permanente, de 0% a 78%. El modelo general sí “veía” la diferencia (los embeddings la contienen); lo que le faltaba era saber cómo llamamos nosotros a cada cosa.
- Las clases difíciles siguen siendo Río (66%) y Autopista (74%), las mismas que en el buscador y en el mapa UMAP de la parte I. Mejorar estas dos requeriría otra información, como imágenes de mayor resolución o las otras bandas del satélite.
- No hay sobreajuste: la exactitud de entrenamiento (86.7%) y la de prueba (85.8%) son casi iguales.
📖 Definición · Sobreajuste y subajuste
- Sobreajuste (overfitting): el modelo memoriza los datos de entrenamiento, incluido su ruido, y falla con datos nuevos. Se detecta cuando la exactitud de entrenamiento es mucho mayor que la de prueba.
- Subajuste (underfitting): el modelo es demasiado simple para capturar los patrones. Las dos exactitudes son parecidas, pero bajas.
¿Cuántos datos necesitamos?
Etiquetar imágenes cuesta tiempo y dinero, así que la pregunta práctica es: ¿cuántos ejemplos por clase hacen falta? Para responderla construimos una curva de aprendizaje: entrenamos el mismo modelo con 1, 2, 5, 10, 20, 50 y 150 imágenes por clase. Como con pocas imágenes el resultado depende mucho de cuáles nos tocan, repetimos cada caso 10 veces con muestras distintas y promediamos.
for n in [1, 2, 5, 10, 20, 50, 150]:
    for r in range(10 if n < 150 else 1):
        # n imágenes al azar de cada clase del conjunto de entrenamiento
        idx = np.concatenate([rng.choice(np.where(y_train == k)[0], n, replace=False)
                              for k in range(10)])
        modelo_n = LogisticRegression(max_iter=3000).fit(X_train[idx], y_train[idx])
        resultados.append((n, modelo_n.score(X_test, y_test)))
De la curva podemos leer varias cosas:
- Con una sola imagen por clase (10 en total) ya igualamos al zero-shot: 46.3% contra 44.8%.
- Con 5 por clase llegamos a 65.2%, y con 20 a 77.1%. Etiquetar 200 imágenes es trabajo de una tarde.
- Rendimientos decrecientes: pasar de 1 a 20 imágenes por clase aporta 31 puntos, pero pasar de 20 a 150 (7.5 veces más datos) aporta 8.7.
- Con pocos datos, importa cuáles nos tocan: la banda sombreada es ancha con 1 o 2 imágenes por clase y casi desaparece a partir de 20.
Bonus: el buscador también es un clasificador
La regresión logística no es el único modelo posible sobre los embeddings. Un k-vecinos más cercanos (k-NN) con distancia coseno clasifica cada imagen buscando sus k imágenes más parecidas en el conjunto de entrenamiento y asignándole la clase más común entre ellas. Es decir: un k-NN es el buscador de la parte I, más una votación.
| Modelo | Exactitud |
|---|---|
| k-NN (k = 1) | 82.6% |
| k-NN (k = 5) | 85.0% |
| k-NN (k = 15) | 83.0% |
| Regresión logística | 85.8% |
Con k = 5 llega prácticamente a lo mismo que la regresión logística. Con k = 1 baja, porque depende de un solo vecino, que puede ser engañoso.
Buscar imágenes escribiendo una frase
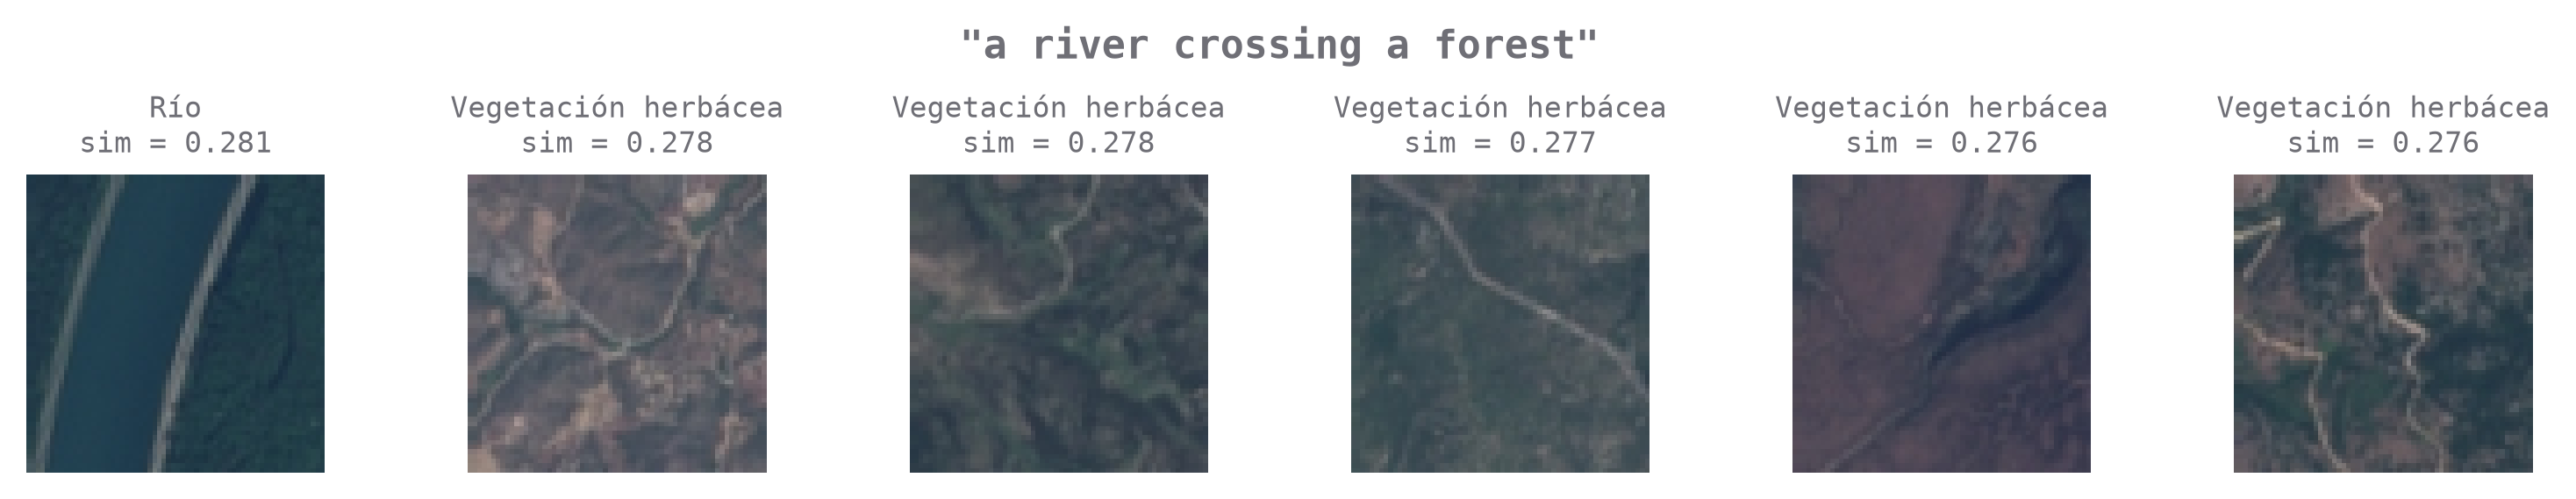
Para cerrar, regresemos al buscador. Como los textos y las imágenes viven en el mismo espacio, el buscador de la parte I también funciona con una frase como consulta. Esto es la base de los buscadores semánticos de fotos, como escribir “playa” en la galería de tu teléfono.
def buscar_por_texto(frase, k=6):
    t = embeddings_de_textos([frase])[0]
    similitudes = X @ t
    return np.argsort(-similitudes)[:k]
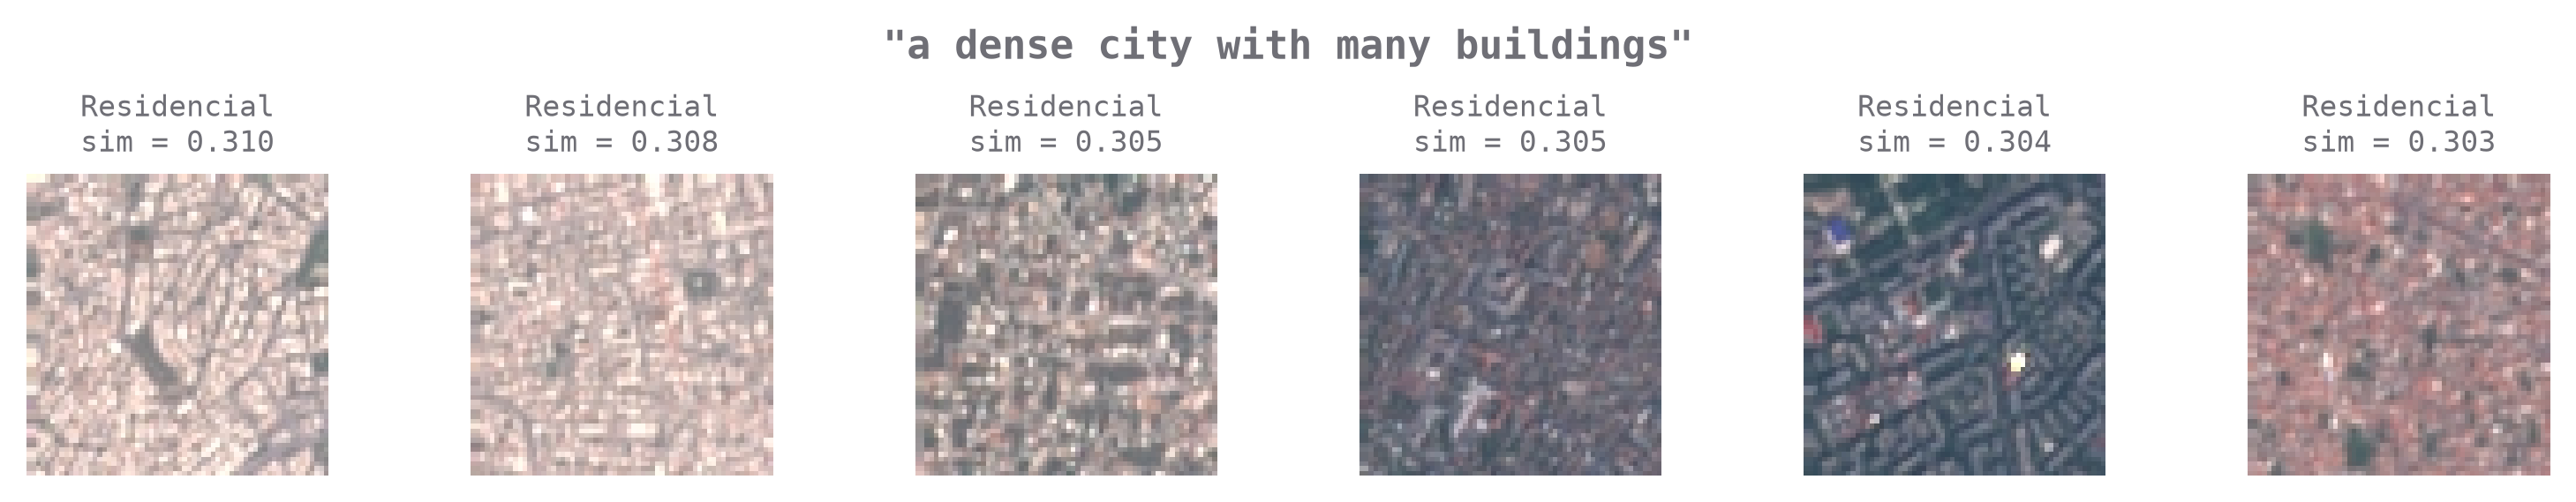
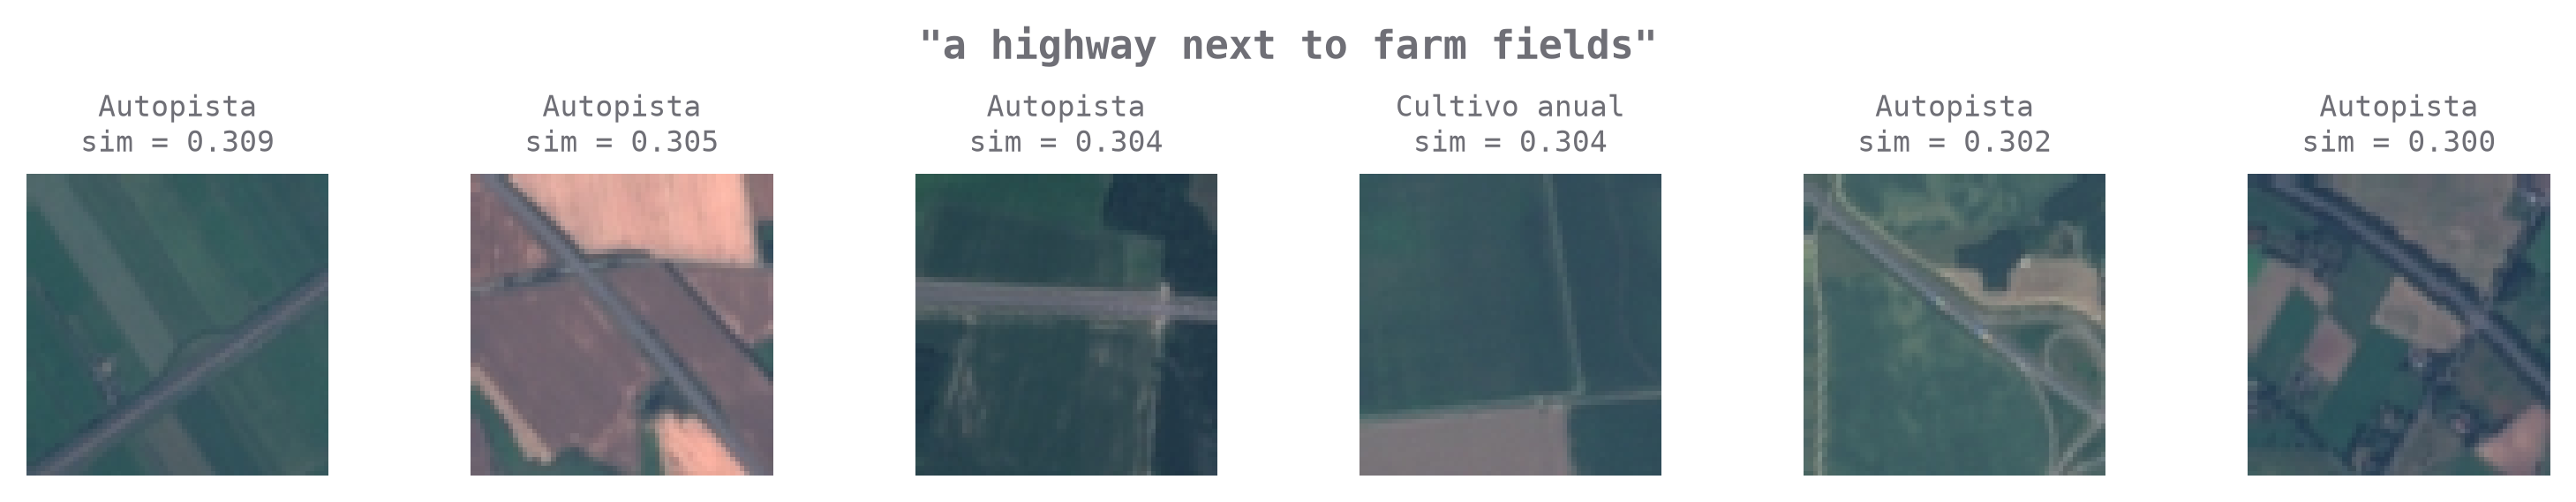
- Las búsquedas funcionan bien cuando la frase describe algo visible: “a dense city with many buildings” devuelve 6 de 6 zonas residenciales, y “a highway next to farm fields” devuelve 5 autopistas rodeadas de cultivos.
- También vemos los límites del modelo: con “a river crossing a forest” solo el primer resultado es un río; los demás son vegetación con caminos sinuosos. Para CLIP, a esta resolución, “una línea que serpentea entre vegetación” es lo más parecido a un río.
- Las similitudes texto-imagen (≈ 0.3) son mucho más bajas que las de imagen-imagen (≈ 0.95). Es normal en CLIP: los textos y las imágenes ocupan regiones distintas del espacio compartido. Lo que importa es el orden, no el valor absoluto.
Conclusiones
Juntando las dos partes de la serie, estos son los resultados:
| Método | Datos etiquetados | Exactitud |
|---|---|---|
| Al azar | 0 | 10.0% |
| Zero-shot con el nombre de la clase | 0 | 36.6% |
| Zero-shot con “a centered satellite photo of …” | 0 | 44.8% |
| Regresión logística sobre embeddings | 5 por clase | 65.2% |
| Regresión logística sobre embeddings | 20 por clase | 77.1% |
| Regresión logística sobre embeddings | 150 por clase | 85.8% |
Volviendo a la pregunta del inicio, ¿basta un modelo de IA general para entender imágenes de un dominio específico?
- Para explorar y buscar, sí. Sin una sola etiqueta, los embeddings de CLIP organizan el dataset por contenido, permiten un buscador con 78.8% de precisión y hasta buscar con frases.
- Para clasificar con las categorías de nuestro problema, no del todo. El zero-shot se queda en 44.8%, porque el modelo no conoce nuestro vocabulario técnico ni el aspecto de nuestras imágenes.
- La combinación es lo que mejor funciona: el modelo general aporta la representación (los embeddings) y nuestros datos aportan el conocimiento del dominio. Con 20 imágenes etiquetadas por clase pasamos de 44.8% a 77.1%, y con 150 a 85.8%, sin entrenar ninguna red neuronal.
Algo que me gusta mucho de este ejercicio es que, una vez que tenemos la tabla de 2,000 × 512, todo lo demás (PCA, división entrenamiento/prueba, regresión logística, k-NN, matriz de confusión) es exactamente lo que se hace con cualquier dataset tabular. Los embeddings son una forma de ingeniería de características automática, y eso los convierte en un gran puente entre la ciencia de datos clásica y los modelos de IA modernos.
Limitaciones
- Las imágenes son pequeñas: CLIP espera imágenes de 224 × 224, así que las de 64 × 64 se amplían y pierden detalle.
- CLIP se entrenó con fotos de internet, donde hay pocas imágenes satelitales. Existen modelos del mismo tipo entrenados con imágenes de percepción remota que suelen funcionar mejor en este dominio.
- Solo usamos 3 de las 13 bandas de Sentinel-2. Las bandas infrarrojas distinguen muy bien la vegetación, el agua y las zonas construidas.
- Los datos son de Europa: antes de usar algo así en México habría que verificar que funcione con nuestros paisajes, cultivos y ciudades.
- Trabajamos con una muestra de 2,000 imágenes y un conjunto de prueba de 500, así que los porcentajes pueden variar algunos puntos con otra muestra.
Para seguir explorando
Si quieres jugar con el notebook, te dejo algunas ideas:
- Usa más datos: aumenta el número de imágenes por clase (con GPU, las 27,000 imágenes toman pocos minutos) y repite la curva de aprendizaje.
- Ajusta la regresión logística: prueba distintos valores del parámetro de regularización
Cusando validación cruzada. - Busca con tus propias frases: ¿qué devuelve “a golf course” o “an airport”? ¿Por qué?
- Escala el buscador: para millones de imágenes se usan bases de datos vectoriales (como FAISS), que encuentran vecinos cercanos sin comparar contra todo el dataset.
Referencias
- Helber, P., Bischke, B., Dengel, A. y Borth, D. (2019). EuroSAT: A Novel Dataset and Deep Learning Benchmark for Land Use and Land Cover Classification. IEEE Journal of Selected Topics in Applied Earth Observations and Remote Sensing.
- Radford, A. et al. (2021). Learning Transferable Visual Models From Natural Language Supervision. ICML.
- CLIP ViT-B/32 en Hugging Face.
- Documentación de
LogisticRegressionyKNeighborsClassifieren scikit-learn. - Repositorio del taller: github.com/RodolfoFerro/buscador-imagenes-ia.
SOBRE EL USO DE INFORMACIÓN TOTAL O PARCIAL: 🔐
- Estos documentos fueron originalmente creados por el autor.
- Cualquier uso de estos documentos o sus contenidos están permitidos a través de la licencia provista y sus condiciones.
- Para cualquier aclaración, puedes contactar al autor: https://rodolfoferro.xyz/
Copyright (c) 2026 Rodolfo Ferro
Rodolfo Ferro
With great power comes great responsibility.